Серверы доступны, база данных отвечает, приложение принимает запросы. Но покупатели долго ждут подтверждения заказа, сотрудники не могут завершить операцию, а поддержка получает обращения о проблемах. На дашбордах появляются предупреждения: выросло время ответа, увеличилась очередь, участились ошибки. Каждое уведомление описывает отдельный симптом. Чтобы восстановить работу, инженеру нужно собрать общую картину и определить, с чего начать проверку.
Искусственный интеллект в мониторинге помогает анализировать такие ситуации. Он может обнаруживать отклонения от обычного поведения системы, сопоставлять связанные события, выделять вероятные причины проблем и прогнозировать изменение показателей. Генеративный искусственный интеллект добавляет возможность задавать вопросы на естественном языке и получать объяснения на основе данных мониторинга.
Возможности зависят от реализации: система обнаружения аномалий, инструмент анализа причин и ИИ-ассистент решают разные задачи. Их польза определяется качеством данных и тем, насколько результаты помогают команде принимать решения. Разберём, как устроен ИИ-мониторинг, где он полезен и как оценить его работу на конкретном приложении или бизнес-операции.
Что такое ИИ-мониторинг и как он связан с AIOps
ИИ-мониторинг — это применение методов искусственного интеллекта для анализа данных о работе приложений, сервисов и ИТ-инфраструктуры. Такие методы помогают находить закономерности, распознавать отклонения, сопоставлять события и готовить выводы для специалистов.
Обычный мониторинг тоже анализирует информацию. Он рассчитывает показатели, проверяет условия, отображает состояние компонентов и отправляет уведомления. Например, система может сообщить, что свободное место на диске заканчивается, доля ошибок превышает допустимый уровень или очередь растёт несколько минут подряд.
Для многих задач понятного правила достаточно. Если отказ оборудования имеет однозначный признак, сложная модель не обязательно улучшит его обнаружение. Искусственный интеллект становится полезнее там, где поведение зависит от нескольких факторов, а значимость отдельного сигнала трудно определить без контекста.
Например, время ответа приложения меняется вместе с нагрузкой, составом запросов и временем суток. Один и тот же показатель может быть нормальным во время распродажи и подозрительным ночью. Машинное обучение позволяет оценивать текущее поведение относительно изученных закономерностей.
Мониторинг, наблюдаемость и AIOps
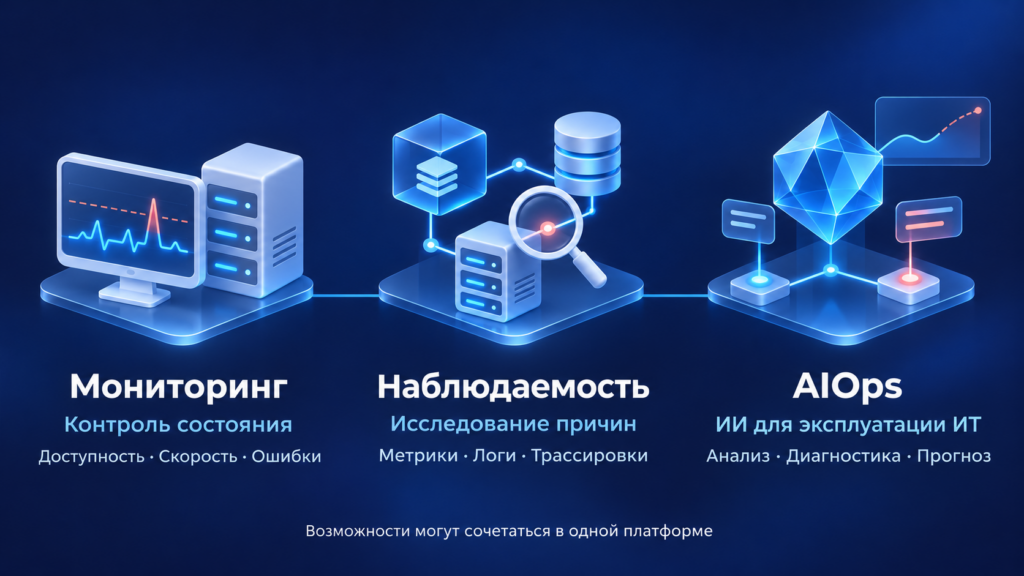
Мониторинг позволяет контролировать выбранные характеристики системы: доступность, производительность, ошибки, нагрузку и потребление ресурсов. Его задача — своевременно предоставить информацию о состоянии объектов и значимых изменениях.
Наблюдаемость, или observability, позволяет исследовать внутреннее поведение системы по её сигналам. Для этого используются метрики, логи, трассировки и другие данные. Команда может переходить от пользовательского симптома к конкретному этапу операции, сервису или инфраструктурному компоненту.
AIOps расшифровывается как Artificial Intelligence for IT Operations — применение искусственного интеллекта к задачам эксплуатации ИТ. Эта область включает анализ событий, диагностику, прогнозирование, работу с инцидентами и другие процессы. ИИ в мониторинге является частью такого подхода.
На практике эти возможности могут сочетаться. Платформа собирает телеметрию, показывает зависимости, контролирует заданные условия, применяет модели для анализа и предоставляет инструменты исследования. Название категории само по себе не определяет глубину реализации.
Какие технологии могут использоваться
Под общим обозначением «искусственный интеллект» встречаются разные механизмы:
- модели машинного обучения для обнаружения аномалий и прогнозирования;
- алгоритмы группировки и классификации событий;
- анализ графа зависимостей между компонентами;
- языковые модели для работы с вопросами и текстовыми объяснениями;
- сочетание моделей с правилами и статистическими методами.
Поэтому оценивать решение лучше через конкретную функцию. Что получает система на входе? Какую задачу выполняет? Что выдаёт в результате? На основании каких данных инженер может проверить вывод?
| Подход | Что делает | Пример |
| Правила и пороги | Проверяет заданное условие | Уведомляет о превышении допустимой доли ошибок |
| Статистический анализ | Сравнивает показатели с выбранным ориентиром | Показывает изменение задержки относительно предыдущего периода |
| Машинное обучение | Ищет закономерности и отклонения в данных | Обнаруживает необычную задержку при привычной нагрузке |
| Анализ зависимостей | Учитывает связи компонентов | Выделяет общий сервис у нескольких проблемных операций |
| Генеративный ИИ | Работает с вопросами и полученным контекстом | Готовит сводку событий и объясняет результаты анализа |
Эти подходы полезно сочетать. Критичные условия контролируются понятными правилами, модели помогают анализировать сложное поведение, а диалоговый интерфейс упрощает поиск информации.
Когда искусственный интеллект в мониторинге действительно полезен
Потребность в искусственном интеллекте часто возникает, когда данные уже собраны, но команда тратит много времени на их интерпретацию. Инженеру приходится открывать несколько представлений, выбирать интервалы, искать связанные события и восстанавливать последовательность изменений.
В распределённом приложении одна операция может обращаться к нескольким внутренним сервисам, базе данных, очереди сообщений и внешнему API. Проблема в зависимости проявляется как ошибка или задержка в другой части системы. Изолированный график отдельного компонента не всегда объясняет происходящее.
Высокий уровень информационного шума
Один сбой способен вызвать несколько предупреждений. Приложение сообщает об ошибке, очередь — о накоплении запросов, база данных — о росте ожидания, а инфраструктурный мониторинг — об изменении нагрузки.
Инженер получает набор симптомов, которые нужно связать. Если похожие эпизоды повторяются, значительная часть времени уходит на повторный сбор одной и той же картины. Анализ взаимосвязей помогает группировать события и выделять общий контекст.
Поведение трудно описать постоянными порогами
Нагрузка меняется по времени суток, дням недели и сезонам. Во время акции количество запросов растёт, а после неё возвращается к обычному уровню. Некоторые операции всегда медленнее других.
Если использовать один порог для всех условий, система может регулярно предупреждать об ожидаемых изменениях. Если сделать порог слишком высоким, можно пропустить значимую деградацию. Модель поведения помогает учитывать особенности конкретного объекта.
Причина находится далеко от пользовательского симптома
Покупатель видит медленную оплату. Источник задержки может находиться в сервисе оформления, базе данных, сети или внешней интеграции. Для диагностики нужно проследить операцию и понять, на каком этапе возникло ожидание.
ИИ-анализ полезен, если он сокращает путь от симптома до проверяемой гипотезы: сопоставляет данные, выделяет зависимость и показывает основания для дальнейшего исследования.
Результат зависит от знаний отдельных специалистов
Иногда опытный инженер быстро понимает ситуацию, потому что помнит архитектуру, предыдущие инциденты и особенности сервиса. Другим сотрудникам приходится собирать эти сведения заново.
Единый контекст и инструменты анализа помогают сделать процесс более воспроизводимым. Но знания должны быть представлены в доступных данных: карте связей, истории изменений, описаниях операций и материалах разбора инцидентов.
Начинать внедрение стоит с конкретного вопроса. Например: «Как раньше замечать деградацию оплаты?» или «Как сократить время подготовки гипотезы после релиза?». Такая постановка позволяет определить данные и измерить результат.
Как работает искусственный интеллект в системе мониторинга
Работу искусственного интеллекта в системе мониторинга удобно рассматривать как последовательность: получение данных, подготовка контекста, анализ, формирование результата и проверка. На каждом этапе могут возникать ограничения, которые влияют на итоговый вывод.
Сбор данных о работе системы
Для анализа используются разные типы телеметрии.
Метрики описывают числовые характеристики: время ответа, количество запросов, долю ошибок, загрузку процессора, потребление памяти, размер очереди.
Логи фиксируют события: ошибки, изменения состояния, результаты выполнения операций и сообщения приложения.
Трассировки показывают прохождение запроса через компоненты и помогают исследовать длительность отдельных этапов.
Например, метрика показывает, что оформление заказа замедлилось. Трассировка помогает найти этап, на котором возникло ожидание. Логи уточняют, какая ошибка произошла, а история изменений показывает, что незадолго до этого вышла новая версия приложения.
Состав данных зависит от задачи. Для прогноза заполнения диска может хватить истории потребления места. Для поиска причины сбоя оплаты нужны сведения о всей цепочке операции.
Подготовка общего контекста
До анализа важно понять, к чему относятся сигналы. Нужны идентификаторы сервисов, окружений, версий и объектов. События должны корректно сопоставляться по времени.
Если данные тестового и рабочего окружений смешаны, система может обнаружить отклонение, которое не касается пользователей. Если сервис переименовали, история способна разделиться на два объекта. Если часы компонентов расходятся, последовательность событий будет восстановлена неточно.
Подготовка контекста также включает обработку пропусков и неоднородных форматов. Отсутствующее значение отличается от нулевого. Запоздавшее событие отличается от события, которое произошло позже. Эти особенности важны для интерпретации.
Определение обычного поведения
Норма зависит от объекта и режима работы. Для одного приложения утренний пик ожидаем, для другого необычен. Время ответа одной операции нельзя автоматически использовать как ориентир для другой.
При анализе временных рядов система может учитывать повторяемость, тренд и связь показателей с нагрузкой. При исследовании событий — историю похожих эпизодов, типы сообщений и зависимости компонентов.
Поведение модели нужно проверять после изменений. Новая версия приложения, перераспределение трафика или изменение состава запросов способны сделать прежний ориентир менее подходящим.
Обнаружение отклонений и связей
Модель ищет признаки, соответствующие её задаче. Это может быть нетипичная задержка, необычная частота ошибок, новая группа сообщений или сочетание изменений в нескольких компонентах.
Дальше система может сопоставить сигналы. Например, рост времени оформления заказа, ожидание соединений и ошибки зависимого сервиса рассматриваются в одном контексте, если они относятся к общей операции и временной последовательности.
Связь событий помогает сузить поиск, но её ещё нужно проверить. Совпадение во времени само по себе не устанавливает причину.
Формирование результата анализа
Результатом может быть:
- уведомление об аномалии;
- группа связанных событий;
- список вероятных причин;
- прогноз показателя;
- объяснение ситуации;
- рекомендация по дальнейшей проверке.
Для инженера важна проверяемость. Если система предполагает проблему после релиза, должны быть доступны событие изменения и связанные признаки деградации. Если указывает на зависимый сервис — данные о соответствующих обращениях.
Полезный ответ показывает объект, интервал и основания вывода. Формулировка «найдена проблема» без этих деталей редко помогает выбрать действие.
Проверка гипотезы и контроль восстановления
Инженер сопоставляет результат с архитектурой, проверяет альтернативные объяснения и выбирает способ восстановления. После действия нужно убедиться, что улучшилась сама операция.
Например, снижение нагрузки на сервер не доказывает, что покупатели снова могут оплатить заказ. Требуется проверить успешность оплаты, время выполнения и состояние зависимых этапов.
Рекомендация и исполнение действия — отдельные возможности. Система может предложить откат релиза, но право и возможность выполнить его определяются инструментами, доступами и процессом эксплуатации.
Какие задачи решает искусственный интеллект в мониторинге ИТ-систем
Обнаружение аномалий
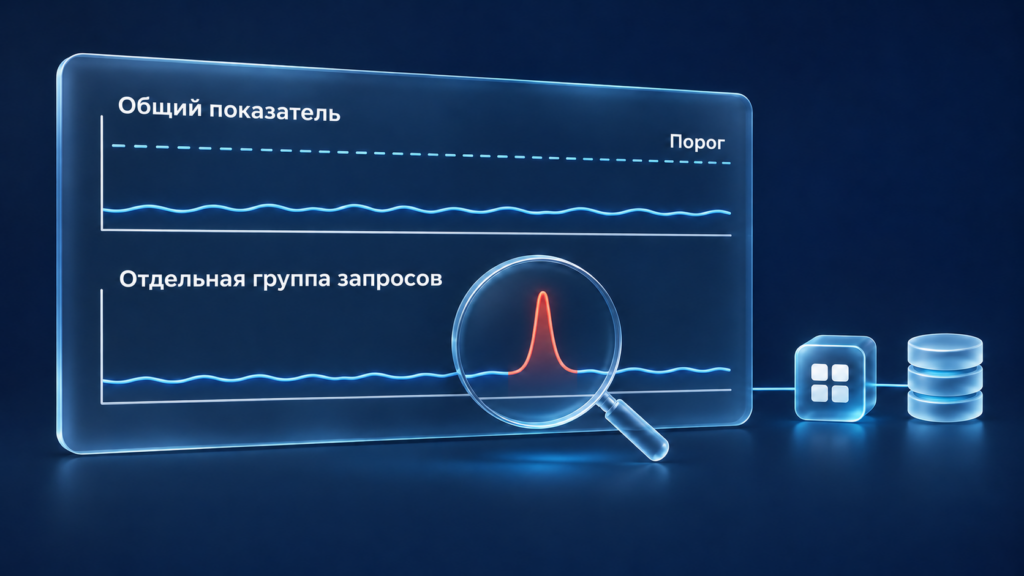
Аномалия — поведение, которое отличается от выбранного представления о норме. Например, операция стала медленнее при прежней нагрузке или ошибки появились только в определённом сегменте запросов.
Общий порог при этом может ещё не сработать. Средняя задержка остаётся приемлемой, но часть пользователей уже сталкивается с проблемой. Анализ по операции, версии или другому признаку помогает увидеть изменение.
Представим сервис, у которого вечером регулярно увеличивается число запросов. Высокая загрузка в этот период ожидаема. Подозрительным может быть рост задержки при обычном объёме обращений или необычное увеличение ошибок у одного типа операции.
Модели могут учитывать несколько признаков одновременно. Умеренная загрузка процессора при долгом ожидании ответа может указывать на зависимость, сеть или ресурс, который не отражён в графике CPU. Высокая загрузка при стабильном качестве операции, наоборот, не всегда требует вмешательства.
При оценке обнаружения аномалий нужно проверить разные эпизоды: реальную деградацию, обычный пик, обслуживание и изменение после релиза. Это покажет, насколько система различает значимые проблемы и ожидаемое поведение.
Отдельный вопрос — когда аномалия должна превращаться в уведомление. Не каждое отклонение требует срочного действия. Часть сигналов полезно сохранять для исследования, часть — направлять владельцу сервиса, а критичные — дежурному инженеру.
Снижение информационного шума и группировка событий
Избыточные уведомления усложняют работу. Специалист тратит время на просмотр повторов и может пропустить важный сигнал среди похожих сообщений.
Снизить эту нагрузку помогают три функции. Дедупликация убирает повторные уведомления. Группировка объединяет разные события, которые относятся к одному инциденту. Корреляция выявляет связи между сигналами. Для этого система может использовать заданные правила, статистику, сведения о связях компонентов и машинное обучение.
Например, при сбое внешнего API несколько внутренних сервисов начинают ждать ответ, повторять запросы и сообщать об ошибках. Система может объединить эти уведомления как признаки одной возможной проблемы. При этом каждое исходное событие остаётся доступным для подробного анализа.
Система должна показывать, почему уведомления объединены: затронутые сервисы зависят от одного компонента, участвуют в одной пользовательской операции или выдают ошибки в определённой последовательности. Это помогает инженеру понять, с чего начать проверку.
Поиск первопричины инцидента
Анализ первопричин помогает установить, где возникла проблема и как она повлияла на остальные части системы. В оперативной диагностике это может быть зависимый сервис, запрос к базе данных, изменение конфигурации или нехватка ресурса.
Для анализа нужны связи компонентов и последовательность событий. Если несколько операций используют одну базу данных и начинают замедляться после появления блокировок, общая зависимость становится важной гипотезой.
Если ухудшение наблюдается только у новой версии приложения, следует проверить изменения этой версии. Если все версии одинаково ждут внешний API, искать только в последнем релизе будет преждевременно.
Самая заметная аномалия не обязательно является источником проблемы. Увеличение повторных запросов может быть следствием задержки. Перегрузка приложения — результатом накопившейся очереди. Поэтому важно анализировать путь операции и начало изменений.
Результат автоматического анализа полезно представлять как проверяемую гипотезу. Инженер должен понимать, какие признаки её поддерживают и какие альтернативы ещё остаются.
Причина текущей деградации и причины, выявленные на последующем разборе, могут отличаться по уровню. Исправление запроса восстановит производительность, а постмортем покажет, почему изменение попало в рабочую среду без нужной проверки.
Прогнозирование нагрузки и ресурсов
Прогнозирование помогает оценить будущее значение показателя при определённых условиях. Например, когда закончится свободное пространство, как изменится очередь или насколько вырастет потребление ресурса.
Если показатель имеет устойчивый тренд, прогноз может дать время на подготовку. Команда заранее планирует увеличение ёмкости, изменение конфигурации или перераспределение нагрузки.
Прогноз метрики следует отличать от предсказания любого сбоя. Постепенное заполнение хранилища содержит наблюдаемые признаки. Внезапный отказ из-за нового дефекта может не иметь доступных предвестников.
Полезный прогноз включает горизонт и допущения. Если модель ожидает обычную динамику, незапланированная акция способна изменить результат. После изменения архитектуры прежняя связь нагрузки и потребления ресурсов тоже может перестать работать.
Проверять нужно не только точность, но и своевременность. Предупреждение полезно, если оставляет достаточно времени для действия. Для ресурса, расширяемого за несколько минут, и системы, требующей длительного согласования, нужный горизонт будет разным.
Ошибочные прогнозы также входят в оценку. Если система часто предупреждает об исчерпании, которое не происходит, команда перестаёт доверять сообщениям. Если предупреждает слишком поздно, возможностей для предотвращения проблемы остаётся мало.
Приоритизация по влиянию на пользователей
Технически похожие отклонения могут иметь разную значимость. Задержка вспомогательной задачи и ошибка оплаты требуют разного внимания.
Чтобы определить приоритет, необходимо понимать, какие операции зависят от компонента. Связь телеметрии с пользовательским действием помогает увидеть, кого затронуло ухудшение и насколько широко оно распространилось.
Полезны разрезы по операциям, версиям, устройствам и другим признакам. Общий показатель может выглядеть стабильным, хотя определённая группа пользователей регулярно получает ошибки.
Для контроля качества используются SLI и SLO. SLI — измеримый показатель, например доля успешно завершённых операций. SLO — целевой уровень этого показателя за выбранный период.
Такие ориентиры позволяют обсуждать значимость событий через ожидаемое качество сервиса. Но сначала нужно согласовать, что считается успешной операцией, какой интервал измеряется и какие исключения допустимы.
Финансовое влияние требует дополнительных данных. Снижение числа заказов может объясняться трафиком, ассортиментом, маркетингом или технической проблемой. Мониторинг помогает исследовать техническую составляющую, а оценка потерь должна учитывать остальные факторы.
Измеренный факт и расчётный вывод следует показывать отдельно. Рост ошибок оплаты — наблюдаемый результат. Возможная упущенная выручка — оценка с определёнными допущениями.
Зачем в мониторинге нужен MCP
Model Context Protocol, или MCP, позволяет организовать обмен контекстом между ИИ-приложением и внешними системами. Через MCP-сервер могут предоставляться данные и функции, к которым обращается ассистент.
В мониторинге это может быть получение сведений о сервисах, событиях, метриках, проблемах и других объектах. Конкретный состав определяется реализацией и правами доступа.
Последовательность выглядит так:
- Пользователь задаёт вопрос.
- Ассистент определяет, какая информация нужна.
- Через доступные инструменты получает данные.
- Анализирует результат.
- Формирует ответ и основания для выводов.
MCP обеспечивает способ взаимодействия. Анализ и качество объяснения зависят от моделей, инструментов и полученной информации.
Наличие MCP-сервера само по себе не означает, что система умеет прогнозировать сбои или автоматически исправлять инфраструктуру. Для каждой функции нужны соответствующие данные и механизмы.
Как проверять диалоговые ответы
Хороший ответ должен соответствовать вопросу по объекту, интервалу и задаче. Если инженер спрашивает о конкретной версии, ассистенту важно анализировать именно её.
Фактические утверждения должны опираться на полученные сведения. Предположение о причине нужно отделять от подтверждённого события. При нехватке данных система должна показывать ограничение.
Полезно проверять и неоднозначные запросы. Например, «Что произошло вчера?» не определяет сервис и может подразумевать разные интервалы. Ассистент должен уточнить вопрос или явно обозначить выбранные параметры.
Диалоговая функция и аналитическая модель оцениваются отдельно. Точное обнаружение аномалии не гарантирует корректного объяснения, а удобный ответ не подтверждает качество диагностики.
Как искусственный интеллект помогает разобраться в сбое: пример оформления заказа в интернет-магазине
Рассмотрим условный пример интернет-магазина. Он показывает последовательность исследования и не описывает результат конкретного внедрения.
Шаг 1. Обнаружить ухудшение операции
После обновления сервиса оформления часть покупателей дольше ждёт подтверждения заказа. Главная страница и каталог работают, приложение доступно.
Проверка общей доступности не показывает полного масштаба проблемы. Наблюдение за оформлением фиксирует рост задержки и появление ошибок ожидания.
Важен разрез по версии. Ухудшение наблюдается у запросов, которые обрабатывают обновлённые экземпляры сервиса. По общему среднему значению проблема выглядит менее выраженной.
Система обнаружения аномалий может выделить изменение относительно обычного поведения операции. Следующая задача — установить, какой этап стал медленнее.
Шаг 2. Восстановить путь запроса
Для покупателя оформление выглядит как одно действие. Внутри выполняются проверка наличия, расчёт условий, сохранение заказа и обращения к зависимым системам.
Трассировки помогают увидеть длительность этапов. В нашем примере выросло время работы с базой данных и ожидание свободного соединения.
Одновременно в логах приложения появляются ошибки ожидания. Метрики показывают, что соединения остаются занятыми дольше обычного.
Эти сигналы относятся к одной операции, но описывают разные стороны проблемы. Их сопоставление помогает сформировать общий контекст.
Шаг 3. Сопоставить события и изменения
История показывает, когда была обновлена версия сервиса. После этого изменилось время выполнения одного из запросов к базе данных.
Если система поддерживает соответствующий анализ, она может выделить гипотезу: изменение запроса увеличило длительность работы с базой, соединения стали освобождаться медленнее, последующие операции начали ждать.
Такой вывод должен сопровождаться основаниями: версией приложения, интервалом, показателями и участком трассировки. Тогда инженер может проверить связь.
Просто сообщить «проблема в базе данных» недостаточно. База может быть местом проявления, а изменение — находиться в коде приложения.
Шаг 4. Проверить альтернативные объяснения
Команда проверяет, не выросла ли нагрузка, не началось ли обслуживание и не изменились ли другие условия.
Сравниваются запросы старой и новой версий. Исследуются блокировки, длительность выполнения и характер ожидания. Уточняется, затрагивает ли проблема все операции или только определённый сценарий.
Эти проверки позволяют отделить совпадение от обоснованной причины. Если ухудшение одинаково у всех версий и связано с внешним фактором, гипотезу о релизе придётся пересмотреть.
ИИ полезен, если помогает быстрее подготовить такую проверку. Окончательное решение опирается на факты и знание архитектуры.
Шаг 5. Выбрать действие и проверить восстановление
В условном примере команда может исправить запрос или откатить версию, если это допустимо по действующим процедурам.
Увеличение числа соединений может временно изменить симптомы, но не обязательно устранит источник задержки. Выбор действия зависит от подтверждённой причины и возможных последствий.
После восстановления проверяются несколько уровней:
- длительность проблемного обращения к базе;
- ожидание соединений;
- время оформления заказа;
- доля успешно завершённых операций;
- состояние отдельных сегментов запросов.
Если улучшился только инфраструктурный показатель, работа ещё не закончена. Важно подтвердить, что покупатель снова может завершить операцию с ожидаемым качеством.
Что изменилось благодаря искусственному интеллекту
При наличии нужных функций система помогла выделить отклонение, связать симптомы и подготовить гипотезу. ИИ-ассистент мог собрать данные о версии, событиях и показателях в общей сводке.
Команда получила более короткий путь к проверке. Но результат зависел от видимости операции, доступной истории и корректных связей между объектами.
Если событие релиза отсутствует, нельзя достоверно указать его время. Если обращение к базе не наблюдается, нельзя уверенно описать изменение запроса. Эти пробелы должны оставаться видимыми.
После эпизода полезно зафиксировать, какие выводы помогли, какие оказались ошибочными и где данных не хватило. Это даст основу для улучшения мониторинга и оценки следующего инцидента.
Как АппОптима использует искусственный интеллект для диагностики и оценки влияния сбоев на бизнес
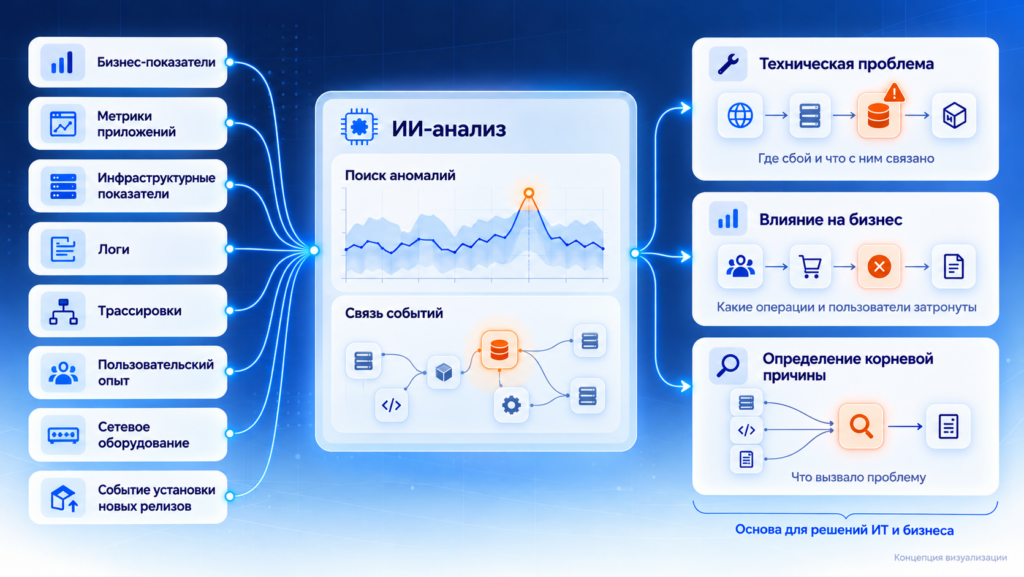
АппОптима анализирует связанные данные о пользовательском опыте, работе приложений, сервисов и инфраструктуры. Искусственный интеллект помогает пройти путь от обнаружения отклонения до понимания его причины, последствий и возможных действий. Техническая команда быстрее разбирается в инциденте, а руководитель видит, какие операции страдают и что нужно восстановить в первую очередь.
В системе используются два взаимодополняющих механизма. AI/ML-анализ обнаруживает аномалии, сопоставляет события и помогает искать первопричины. MCP-модуль предоставляет доступ к данным платформы через ИИ-ассистента: сотрудник задаёт вопрос на естественном языке и получает объяснение с учётом технических данных и доступного бизнес-контекста.
Обнаружение проблем до критического ухудшения
AI/ML-модели изучают нормальное поведение системы и выявляют нетипичные изменения, в том числе когда показатели ещё не пересекли заданные пороги. Это помогает замечать ранние признаки деградации и начинать проверку до того, как проблема перерастёт в серьёзный сбой.
ИТ-команда получает дополнительное время на диагностику и подготовку действий. Например, при постепенном замедлении оформления заказа специалисты могут начать проверку до того, как задержки станут массовыми. Такое обнаружение применимо к проблемам с наблюдаемыми ранними признаками и не означает гарантированного предсказания любого отказа.
Поиск причины по связанным данным
Одна техническая проблема может вызвать множество событий: рост задержек, накопление запросов и ошибки в нескольких сервисах. АппОптима сопоставляет метрики, логи, трассировки и события по времени и зависимостям между компонентами. Это помогает рассматривать симптомы вместе и определить, где началось ухудшение: в коде приложения, инфраструктуре или внешней интеграции.
Инженеру приходится меньше времени тратить на ручное сопоставление данных. Он получает направление для проверки и может исследовать источник проблемы, а не только её наиболее заметное проявление. Анализ также помогает оценивать последствия обновлений: что изменилось после релиза и какие компоненты связаны с ухудшением.
Чем быстрее команда устанавливает причину, тем раньше она может приступить к восстановлению сервиса. При этом продолжительность сбоя зависит и от выбранного исправления, согласований и процедур его выполнения.
Приоритеты с учётом пользовательских операций
Технический показатель сам по себе не объясняет значимость проблемы для компании. Рост времени ответа может затрагивать вспомогательный сервис или критичный этап оплаты — приоритеты в этих случаях будут разными.
АппОптима связывает технические события с пользовательскими сценариями и, при подключении соответствующих данных, с бизнес-показателями. Это помогает выяснить, какие операции затронуты, как проблема проявляется у пользователей и какое ухудшение требует первоочередного внимания.
Владелец сервиса получает основания для расстановки приоритетов, а техническая команда — понимание того, какие операции важнее восстановить в первую очередь. Обсуждение инцидента становится предметным: какие действия пользователей нарушены и какие процессы компании от этого зависят.
При подключённых бизнес-метриках ИИ-ассистент также может помогать оценивать упущенную выручку. Такая оценка должна опираться на данные компании и понятные допущения: число технических ошибок само по себе не равно числу потерянных продаж.
ИИ-ассистент для исследования инцидентов
MCP-модуль позволяет обращаться к данным АппОптимы через вопросы на естественном языке. Например:
- «Почему вчера увеличилось время оформления заказа?»
- «Какие операции выполнялись с ошибками во время сбоя?»
- «Что изменилось в производительности после обновления сервиса?»
- «Какая из текущих проблем сильнее влияет на важные операции?»
Ассистент получает нужную информацию из разделов платформы и формирует ответ с учётом взаимосвязей. Сотрудник может исследовать ситуацию через последовательные вопросы, сохраняя связь выводов с исходными данными.
Инженер быстрее собирает общую картину инцидента и меньше времени тратит на поиск информации. Руководитель получает понятное объяснение: что произошло, какие операции затронуты и почему определённая проблема требует внимания. Глубина ответа зависит от данных, доступных для анализа.
Рекомендации для восстановления работы
АппОптима помогает определить возможные действия с учётом причины и влияния проблемы. Среди примеров — откат релиза, перераспределение нагрузки или масштабирование ресурсов.
Техническая команда получает основу для выбора следующего шага: какие меры стоит рассмотреть и с какой обнаруженной проблемой они связаны. Это помогает быстрее перейти от разбора симптомов к подготовке исправления и согласовать приоритет действий с владельцем сервиса.
MCP-модуль не выполняет предложенные действия автоматически. Специалист проверяет выводы по исходным данным и принимает решение с учётом архитектуры и ограничений компании.
Как это выглядит на примере оформления заказа
Предположим, после обновления приложения покупатели стали дольше ждать подтверждения заказа. Это условный сценарий, иллюстрирующий применение возможностей системы.
AI/ML-анализ помогает обнаружить отклонение и сопоставить его со связанными событиями. Инженер через ассистента запрашивает изменения после релиза и исследует, где возникла задержка: в самом приложении, обращении к базе данных или внешнем сервисе. Владелец цифрового продукта уточняет, какие операции и пользователи затронуты. При наличии бизнес-метрик анализ дополняется оценкой последствий для компании.
Команда получает общую основу для решения: вероятную причину, масштаб влияния и варианты действий. После исправления проверяется восстановление самой операции — могут ли покупатели снова завершать заказ с ожидаемым качеством.
В АппОптиме обнаружение отклонений, диагностика и оценка влияния опираются на связанные данные. Инженерам проще проследить путь от пользовательского симптома до проблемного компонента, а руководителям — определить приоритет восстановления по последствиям для клиентов и ключевых процессов.