Покупатель собрал корзину, выбрал доставку и нажал «Оплатить». Но вместо подтверждения заказа видит бесконечную загрузку. После нескольких попыток он закрывает сайт. Для ИТ-команды это проблема в работе приложения, для бизнеса — риск потерять продажу и доверие клиента.
От работы приложений зависят повседневные задачи компаний в самых разных отраслях. В ритейле, интернет-магазинах и сервисах доставки продуктов они обеспечивают путь от поиска товара до получения заказа. В банках — проведение платежей, в страховании — оформление полисов, в логистике — планирование и отслеживание перевозок. Медицинские организации используют приложения для записи пациентов и доступа к результатам обследований, производственные предприятия — для учета материалов и выполнения заказов. Задержки и ошибки мешают клиентам получать услуги, а сотрудникам — выполнять свою работу.
При этом серверы могут работать исправно. Чтобы найти причину проблемы, нужно увидеть, как приложение обрабатывает запрос: к каким компонентам обращается, где тратит время и на каком этапе возникает ошибка. Для этого используют мониторинг производительности приложений — APM.
APM расшифровывается как Application Performance Monitoring. Он помогает отслеживать скорость выполнения операций, выявлять ошибки и находить причины замедлений. Эти данные позволяют ИТ-команде быстрее разобраться в проблеме и восстановить работу важных для бизнеса процессов.
В статье разберем, как работает APM, какие метрики помогает отслеживать и как используется для поиска причин замедлений и ошибок. Сравним ведущие зарубежные инструменты, расскажем, на что обратить внимание при выборе, и рассмотрим возможности российской платформы АппОптима.
Что такое APM
APM (Application Performance Monitoring) — мониторинг производительности приложений. Он позволяет наблюдать, как приложение обрабатывает запросы и выполняет операции: сколько времени занимает каждый этап, где возникают ошибки и какие зависимости влияют на результат.
Например, оформление заказа включает проверку остатков, расчет доставки, применение скидки и создание платежа. Если покупатель долго ждет завершения операции, APM помогает проследить ее выполнение и выяснить, где появилась задержка: при обработке запроса, обращении к базе данных или вызове внешнего сервиса.
Основная задача APM — дать данные для объяснения медленной или нестабильной работы приложения. Время ответа и частота ошибок показывают масштаб проблемы, а детализация выполнения запросов помогает искать ее техническую причину.
История APM связана с развитием средств наблюдения за работой приложений в конце 1990-х и 2000-х годах. Один из ранних этапов — создание Wily Technology в 1998 году. Компания стала одним из пионеров этого направления.
Почему возникла потребность в APM? По мере усложнения приложений одной проверки серверов стало недостаточно. Запрос пользователя мог проходить через несколько компонентов, обращаться к базе данных и ждать ответа другой системы. Каждый компонент оставался доступным, но общая операция выполнялась медленно или завершалась ошибкой.
Показатели CPU и памяти не объясняли, на каком этапе теряется время. Командам требовалось наблюдать за выполнением запросов и связывать задержки с конкретными вызовами. APM позволил перейти от общего состояния инфраструктуры к исследованию производительности самого приложения.
С распространением облаков, микросервисов и частых релизов цепочки взаимодействий стали сложнее. Одна операция могла выполняться в нескольких сервисах, а состав ее участников — меняться после обновления. Поэтому выросла потребность в распределенной трассировке и сопоставлении данных разных компонентов.
Сегодня APM помогает исследовать выполнение операции целиком: увидеть задержку, проверить зависимости и сопоставить поведение приложения до и после изменений. Для бизнеса это важно, потому что техническая проблема может нарушить конкретное действие — оформление заказа, оплату или отправку заявки.
Зачем нужен мониторинг состояния приложения
Мониторинг состояния приложения помогает контролировать, может ли цифровой сервис выполнять задачи пользователей и бизнеса. Работающий процесс, доступный сервер и успешная служебная проверка еще не означают, что покупатель может оплатить заказ, клиент — отправить заявку, а сотрудник — провести документ в корпоративной системе.
APM связывает наблюдение за производительностью с диагностикой: показывает, какие операции замедляются или завершаются ошибкой, какие компоненты участвуют в их выполнении и где искать причину отклонения.
Повышение продаж, конверсии и выручки
В цифровых каналах технический сбой может прервать путь к покупке. Медленный поиск затрудняет выбор товара, ошибка корзины мешает оформить заказ, недоступная платежная интеграция — завершить оплату. Пользователь может повторить попытку, обратиться в поддержку или уйти к конкуренту.
Поэтому важно наблюдать за конкретными этапами: авторизацией, поиском, оформлением, оплатой. Общие показатели приложения могут выглядеть приемлемо, пока один из этих сценариев работает с ошибками. При соединении технической телеметрии с данными операций команда может выяснить, какие действия затронуты и сколько попыток завершилось неуспешно.
Сопоставление с бизнес-аналитикой помогает оценить последствия инцидента: изменение числа оплаченных заказов, завершенных заявок или успешных операций. Для оценки недополученной выручки нужно учитывать повторные попытки, последующие покупки и другие факторы спроса. Не каждая ошибка означает потерянную продажу: APM предоставляет технический контекст для анализа.
Поиск первопричин сбоев и замедлений
Симптом и причина проблемы могут находиться в разных компонентах. Пользователь видит зависшую оплату, сервис заказа фиксирует тайм-аут, а источник задержки — блокировка в базе данных зависимого приложения. Если исследовать только место появления ошибки, команда рискует устранять последствия и пропустить источник сбоя.
APM помогает проследить выполнение запроса, выделить медленный этап и сопоставить его с ошибками, логами и состоянием ресурсов. Для этого используют распределенную трассировку и связь разных видов телеметрии.
Рост времени ответа может быть связан с медленным SQL-запросом, ожиданием свободного соединения, повторными вызовами внешнего API или изменением кода. Детализация позволяет проверить эти гипотезы. Найденный медленный компонент еще не всегда является первопричиной: инженер исследует его зависимости и подтверждает вывод по доступным данным.
Обнаружение деградации приложения до массовых жалоб
Проблема не обязательно начинается с полного отказа. Сначала может увеличиваться длительность операций, расти доля тайм-аутов или накапливаться очередь обработки. Приложение продолжает отвечать, но часть пользователей уже сталкивается с задержками.
Наблюдение за динамикой показателей помогает заметить ухудшение и начать проверку до массового обращения клиентов в поддержку. Например, постепенный рост времени оформления заказа дает повод исследовать зависимость, даже если проверка доступности сайта остается успешной.
Правила оповещения должны учитывать важность операции, обычную нагрузку и продолжительность отклонения. Кратковременный всплеск и устойчивое ухудшение требуют разной реакции. Возможность раннего обнаружения зависит от охвата мониторинга и характера сбоя: мгновенный отказ не всегда имеет предварительные признаки.
Приоритизация инцидентов по влиянию на бизнес
Одновременно могут возникать десятки технических отклонений. Самый заметный график не обязательно указывает на самую важную проблему. Замедление внутреннего отчета и ошибки оплаты требуют разного приоритета, даже если первый сигнал затронул больше запросов.
Связь компонентов с бизнес-операциями помогает определить, какие сценарии нарушены, сколько пользователей затронуто и есть ли обходной путь. По этим данным команда выбирает порядок восстановления: сначала вернуть возможность оформить и оплатить заказ, затем устранить менее критичные отклонения.
Для этого нужно заранее выделить важные операции и их зависимости. Техническая телеметрия без бизнес-контекста показывает масштаб отклонения, но не устанавливает его финансовую значимость.
Проверка релизов и изменений конфигурации
Успешное развертывание новой версии не гарантирует сохранения производительности. Изменение может добавить обращения к БД, увеличить объем обработки или затронуть редкий сценарий. Проверка запуска такие последствия не выявит.
APM позволяет сравнивать время ответа, ошибки и поведение зависимостей до и после релиза. Полезно анализировать конкретные операции при сопоставимой нагрузке: общий показатель может скрыть ухудшение одного API.
Совпадение по времени помогает сформировать гипотезу, но не доказывает, что виноват релиз. Команда проверяет данные и выбирает действие: исправление кода, изменение конфигурации или откат. Затем мониторинг помогает оценить, восстановилась ли работа сценария.
Сокращение затрат на диагностику и эксплуатацию
Без связанного контекста инженеры тратят время на сбор логов, сверку временных отметок и поиск владельцев компонентов. Проблему могут последовательно передавать между разработкой, эксплуатацией и командой БД. Пока причина не установлена, растут трудозатраты и продолжительность нарушения бизнес-процесса.
APM дает общую отправную точку расследования: операцию, запрос, подозрительный этап и связанные показатели. Это помогает определить, какую команду подключить и какие данные ей передать. Подтверждение первопричины также позволяет подготовить изменение для снижения риска повторного инцидента.
Диагностика помогает обосновывать расходы на инфраструктуру. Если запрос ждет внешнюю систему или выполняет неэффективные обращения к БД, увеличение числа серверов может не устранить причину. Данные о выполнении операций позволяют проверить необходимость масштабирования до покупки дополнительных ресурсов.
Общая картина для ИТ и бизнеса
Разработчику нужны место ошибки и детали выполнения кода, эксплуатации — состояние сервисов и зависимостей, ИТ-руководителю — затронутые процессы и ход восстановления. Бизнесу важно понимать, могут ли пользователи завершить покупку или получить услугу.
Мониторинг приложений связывает эти уровни: от нарушенной операции команда переходит к техническим данным, а после исправления проверяет результат. Оценка восстановления опирается на успешное выполнение сценария, а не только на исчезновение уведомления.
Технологии мониторинга приложений: как работает APM
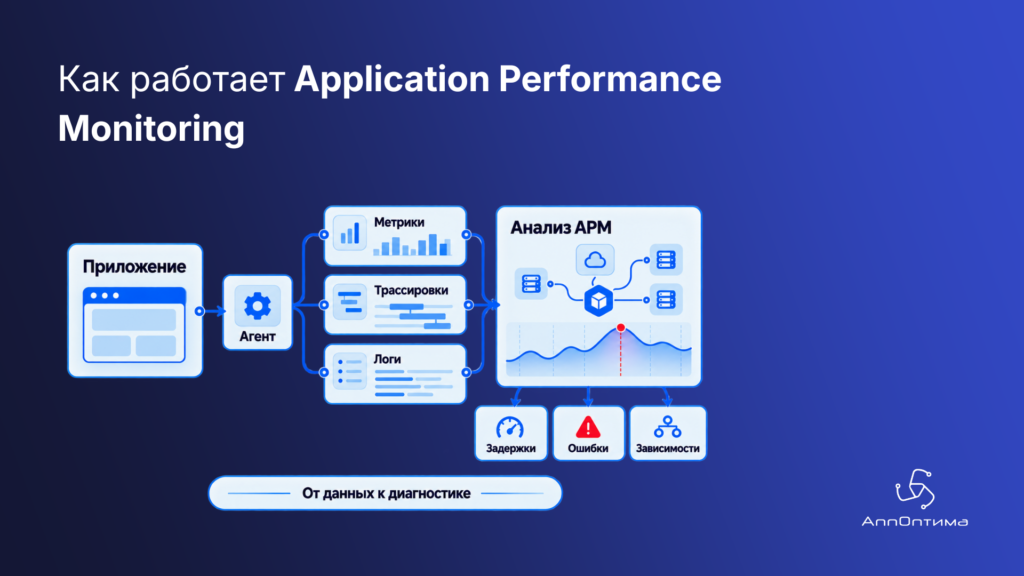
Чтобы исследовать приложение, системе мониторинга нужны данные о его выполнении. Их собирают агенты, библиотеки или SDK. Данные поступают в систему анализа, где команда может увидеть показатели сервисов, исследовать запросы и настроить оповещения.
Агенты и инструментация
Чтобы отслеживать производительность, нужно получать данные о выполнении запросов: когда началась операция, сколько времени она заняла, к каким компонентам обратилась и возникли ли ошибки.
Для этого используют агенты мониторинга и библиотеки, подключенные к приложению. Они фиксируют поддерживаемые операции и передают данные для анализа. Подключение таких механизмов называют инструментацией. Часть данных можно получать автоматически, а для дополнительной детализации — добавлять сбор в код приложения.
Например, при обработке заказа можно измерить длительность обращения к базе данных и вызова сервиса доставки. Эти данные помогают понять, на каком этапе запрос задерживается. Если видна только общая длительность операции, установить причину замедления сложнее: для этого нужна информация об отдельных этапах ее выполнения.
Метрики, трассировки и логи
Каждый вид данных отвечает на свой вопрос:
- Метрики показывают масштаб и динамику: сколько запросов поступает, как меняется время ответа, растет ли доля ошибок.
- Трассировки показывают прохождение отдельного запроса: какие компоненты участвовали и сколько времени занял каждый этап.
- Логи содержат события приложения: исключения, диагностические сообщения и результаты действий.
Эти сигналы используются совместно. Сначала инженер замечает рост ошибок на графике, затем открывает проблемный запрос и изучает связанные события. Для такого перехода данные должны иметь общий контекст — например, идентификатор трассы, сервис и окружение.
Распределенная трассировка
В микросервисном приложении запрос проходит через несколько сервисов. Распределенная трассировка связывает наблюдаемые этапы в общую цепочку. Отдельный этап называют span: он содержит длительность, атрибуты и сведения об операции.
Если создание заказа заняло четыре секунды, трасса помогает выяснить, сколько времени ушло на проверку остатков, расчет доставки и платежный вызов. Но для сохранения цепочки между компонентами нужно передавать контекст трассировки. Разрыв на одной из границ ограничивает диагностику, особенно при работе через очереди.
Вызов внешнего API можно наблюдать со стороны собственного приложения: измерить его длительность и результат. Чтобы увидеть обработку внутри внешней системы, необходима ее телеметрия.
Карта зависимостей и оповещения
Карта зависимостей показывает, какие сервисы взаимодействуют между собой. Она помогает определить участников проблемной операции и оценить, какие приложения могут пострадать от сбоя общего компонента. Полнота карты зависит от подключенного сбора данных.
Оповещения сообщают о значимых отклонениях: росте ошибок, замедлении или необычном поведении. Полезный сигнал содержит контекст для действия — затронутую операцию, сервис, время и масштаб проблемы. Аналитика и ИИ могут помочь выделить вероятную причину, которую инженер затем проверяет.
Какие показатели отслеживает APM
Метрики помогают оценить, насколько быстро приложение выполняет операции, какую нагрузку обрабатывает и как часто возникают ошибки. Их рассматривают вместе и по отдельным сценариям: поиску, авторизации, оформлению заказа или оплате. Так проще заметить проблему, которую скрывают общие показатели приложения.
Скорость, нагрузка и ошибки
| Метрика | Что показывает | На что смотреть |
| Время отклика (Response Time) | Длительность запроса или операции на выбранном участке измерения | Сравнивать одинаковые операции. Уточнять границы: серверная обработка и полный запрос со стороны клиента имеют разную длительность |
| Перцентили p50, p95 и p99 | Распределение времени отклика: в p95 укладываются 95% измеренных запросов | Среднее может скрывать медленные запросы. Анализировать перцентили вместе с числом запросов и периодом измерения |
| Время до первого байта (TTFB) | Время от начала запроса или навигации до получения первого байта ответа — в зависимости от способа измерения | Учитывать серверную обработку и сетевые этапы. Рост TTFB требует проверки причин, но сам по себе не доказывает проблему в приложении или БД |
| Длительность обращений к базе данных | Сколько времени занимают вызовы БД; при соответствующей детализации — выполнение SQL-запросов | Смотреть на медленные и часто повторяющиеся запросы, блокировки и число обращений. Для углубленной диагностики использовать данные БД и планы выполнения |
| Длительность вызовов зависимых сервисов | Сколько занимает обращение к другому сервису или внешнему API | Проверять задержки, тайм-ауты, повторные попытки и число вызовов в одной операции |
| Пропускная способность (Throughput) | Сколько запросов или операций обрабатывается за единицу времени: RPS, RPM или TPS | Сопоставлять с задержками и ошибками. Различать входящий поток и число завершенных операций |
| Одновременно активные пользователи | Сколько пользователей совершает действия в заданном временном окне, если подключен сбор пользовательских данных | Зафиксировать критерий активности. Число активных пользователей, открытых сессий и одновременно выполняемых запросов — разные показатели |
| Доля ошибок (Error Rate) | Процент неуспешных запросов или операций за выбранный период | Разделять HTTP-ответы 4xx и 5xx, исключения, тайм-ауты и бизнес-отказы. Не каждый ответ 4xx означает неисправность приложения |
TTFB включает время установления соединения и другие этапы до получения ответа, а не только обработку на сервере. Поэтому его нужно сопоставлять с серверным временем и сетевыми измерениями.
Длительность вызова БД со стороны приложения также может включать передачу данных и ожидание. Чтобы установить причину медленного SQL-запроса, используют детализацию на стороне БД, включая анализ плана выполнения.
Ресурсы приложения и среда выполнения
Мониторинг ресурсов приложения и мониторинг сервера приложений помогают проверить, связано ли замедление с ограничениями среды выполнения.
| Метрика | Что показывает | На что смотреть |
| Загрузка CPU | Использование процессорных ресурсов процессом или окружением | Совпадает ли рост загрузки с задержками. Низкая загрузка не исключает ожидание БД или внешнего сервиса |
| Использование памяти | Объем занятой памяти; для управляемых сред — также состояние кучи | Устойчивый рост, приближение к лимитам и связь с ошибками или перезапусками |
| Сборка мусора (GC) | Частоту и длительность сборок; паузы — если доступны соответствующие измерения | Совпадают ли изменения GC с ухудшением времени отклика |
| Потоки и пулы соединений | Число потоков, их состояния, занятые соединения и ожидание получения соединения | Есть ли нехватка доступных потоков или соединений, которая задерживает обработку |
| Очереди обработки | Число ожидающих задач или сообщений и время ожидания | Растет ли очередь и успевают ли обработчики выполнять поступающую работу |
Конкретный набор зависит от технологии приложения и подключенного сбора. Например, для JVM предусмотрены метрики памяти, сборки мусора и потоков.
Скорость обнаружения инцидентов
MTTD (Mean Time to Detect) — среднее время от возникновения инцидента до его обнаружения. Это показатель эффективности мониторинга и процесса обнаружения, а не скорости выполнения приложения. Чем он меньше, тем раньше команда получает возможность начать диагностику.
Для расчета MTTD нужно определить момент начала каждого инцидента и момент обнаружения, затем усреднить полученные интервалы. Само появление графиков APM не означает, что этот показатель уже измеряется.
Чем APM отличается от других видов мониторинга
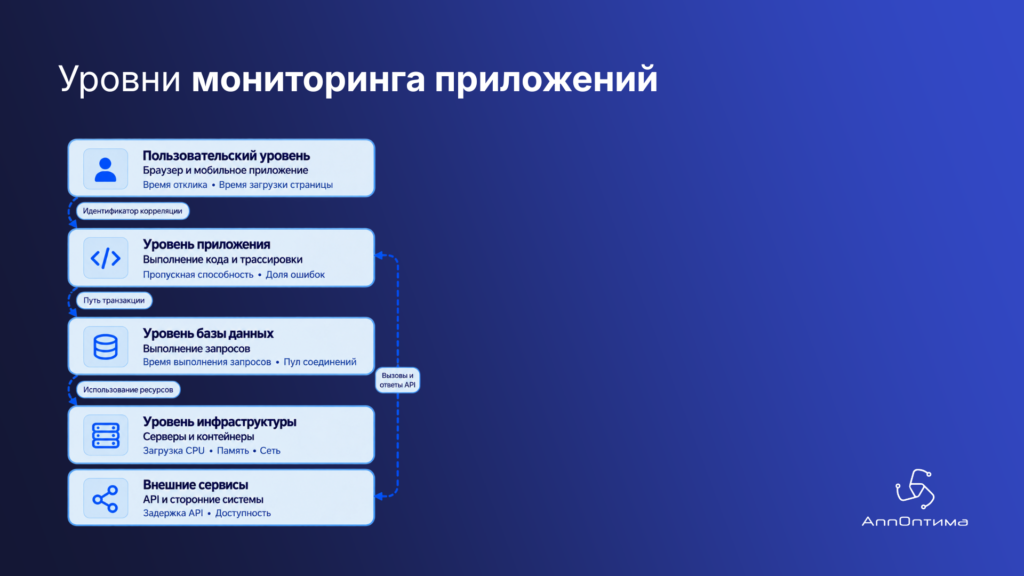
Приложение зависит от инфраструктуры, а пользователь взаимодействует с ним через браузер или мобильный интерфейс. Для полной картины нужны данные разных уровней.
| Подход | Что наблюдает | Основной вопрос |
| Мониторинг инфраструктуры | Серверы, ОС, контейнеры, сеть и другие ресурсы | Есть ли отказ компонента или дефицит ресурсов? |
| APM | Операции приложения и их зависимости | Где появляется задержка или ошибка? |
| RUM | Действия реальных пользователей | Как работает сервис на их устройствах? |
| Синтетический мониторинг | Автоматические проверки заданных сценариев | Выполняется ли операция в контролируемых условиях? |
Эти подходы дополняют друг друга. Инфраструктурные показатели помогают проверить ресурсные причины задержки, APM — исследовать выполнение запроса, пользовательские данные — оценить видимый результат.
Мониторинг веб-приложения: от браузера до бэкенда
Мониторинг веб-приложения должен учитывать клиентскую и серверную части. Если кнопка оплаты долго остается неактивной, причина может находиться в браузерном коде еще до отправки запроса. Если запрос уже ушел на сервер, нужно исследовать его прохождение через бэкенд.
Поэтому время ответа API не заменяет измерение пользовательского опыта. Для полного сценария сопоставляют RUM и APM: от проблемного действия переходят к связанному серверному запросу, если решение поддерживает такую связь.
Серверный агент не обеспечивает наблюдение за браузером автоматически. Сбор клиентских данных подключают отдельно. Аналогично синтетические проверки нужно настраивать под выбранные сценарии: успешное открытие главной страницы не подтверждает работоспособность оплаты.
APM и наблюдаемость
Observability, или наблюдаемость, — способность понимать состояние системы по ее выходным данным. APM поддерживает эту задачу применительно к приложениям.
Практический критерий наблюдаемости — возможность проверить диагностическую гипотезу. Если команда видит рост ошибок, но не может определить операцию, зависимость или затронутую версию, собранных данных может быть недостаточно для расследования.
Как найти первопричину проблемы с помощью APM
Рассмотрим условный интернет-магазин. После обновления сайт остается доступным, но часть покупателей долго ждет оформления заказа. Поддержка получает жалобы, а общая нагрузка на серверы существенно не изменилась.
Шаг 1. Определить границы проблемы
Инженер выясняет, когда началось ухудшение и какие операции затронуты. Каталог и авторизация работают обычно, а p95 оформления заказа вырос. Команда проверяет поток запросов и долю ошибок, чтобы оценить масштаб и отделить замедление конкретного сценария от общей перегрузки.
Шаг 2. Исследовать медленную операцию
В одной трассе серверная обработка занимает 3,8 секунды. Из них 3 секунды приходятся на вызов сервиса доставки. Это направление поиска, но еще не доказанная первопричина: вызов мог включать ожидание соединения или повторную попытку.
Шаг 3. Проверить зависимость
При наличии телеметрии сервиса доставки инженер видит длительное обращение к БД. Затем изучает связанные события и показатели базы. Без этих данных можно было бы установить медленную границу, но не объяснить внутреннюю причину задержки.
Шаг 4. Подтвердить причину и выбрать действие
Команда обнаруживает, что новая версия выполняет дополнительные обращения к БД. Разработчик воспроизводит поведение и проверяет его влияние. После подтверждения выбирают исправление или откат. Совпадение замедления с релизом само по себе недостаточно для такого вывода.
Шаг 5. Проверить технический и бизнес-результат
После изменения команда сравнивает длительность и ошибки при сопоставимой нагрузке. Также проверяет, что заказ успешно создается и проблема не переместилась на другую зависимость. Исчезновение тайм-аута не является достаточным результатом, если пользователь по-прежнему не может завершить покупку.
Топ зарубежных инструментов для мониторинга производительности приложений
Среди зарубежных APM-инструментов выделим Dynatrace, Datadog APM, New Relic, IBM Instana, Elastic APM и Grafana Cloud Application Observability. Их поставщики входят в категорию Leaders в Gartner Magic Quadrant for Observability Platforms 2026. Ниже сравнивнение возможностей этих продуктов для мониторинга производительности приложений.
АппОптима — российская платформа мониторинга производительности приложений
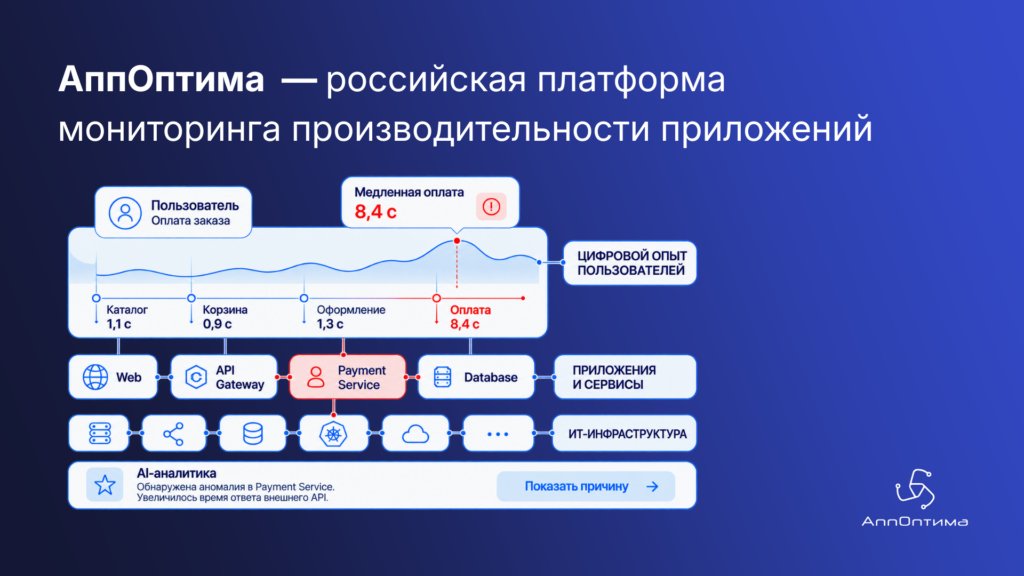
АппОптима помогает понять, как работают приложения, где возникают задержки и почему происходят ошибки. Платформа объединяет APM, мониторинг реальных пользователей и ИТ-инфраструктуры. Благодаря этому команда может исследовать проблему с разных сторон: что произошло у пользователя, как выполнялся его запрос и в каком состоянии находились участвующие компоненты.
Например, клиент не может завершить оформление заказа. Серверы при этом доступны, а общие показатели нагрузки выглядят нормально. Чтобы разобраться, нужно увидеть, какие этапы прошел запрос и где возникла проблема. АппОптима помогает исследовать транзакцию и ее зависимости, перейти к проблемному сервису, а при доступной детализации — к методу или участку кода.
Данные о действиях реальных пользователей дополняют эту картину. Они помогают увидеть ошибки и медленные операции в веб- и мобильных приложениях. Инфраструктурный мониторинг позволяет проверить, связана ли задержка с состоянием ресурсов. Разработка и эксплуатация получают общие данные для расследования и могут быстрее перейти к проверке конкретной причины.
ИИ-анализ помогает выявлять аномалии, сопоставлять связанные события и выделять вероятные первопричины. Это особенно полезно, когда сбой одного компонента вызывает отклонения сразу в нескольких сервисах. Выводы платформы служат основой для дальнейшей проверки: инженер уточняет причину и выбирает способ исправления.
Для бизнеса такой подход помогает:
- Снижать риск потери продаж — выявлять проблемы в оформлении заказа, оплате и других важных операциях.
- Поддерживать качество обслуживания — находить задержки и ошибки, с которыми сталкиваются пользователи.
- Сокращать время диагностики — исследовать приложение и инфраструктуру по связанным данным.
- Правильно расставлять приоритеты — направлять усилия на инциденты, затрагивающие критичные бизнес-процессы.
- Контролировать результат изменений — проверять работу приложения после релиза или исправления.
При этом финансовый эффект оценивают вместе с данными о заказах, платежах и конверсии. Мониторинг помогает понять техническую сторону проблемы, а бизнес-аналитика — ее последствия.
Начать работу с АппОптимой легко: единый агент упрощает подключение и ускоряет внедрение, автоматически обнаруживая поддерживаемые компоненты. Можно начать с приложения, стабильность которого особенно важна для бизнеса.
Выбирайте удобный формат: on-premises в вашей инфраструктуре или SaaS с поминутной оплатой. Это позволяет подобрать вариант использования под задачи и бюджет компании.
Запросите демонстрацию АппОптимы, чтобы увидеть возможности платформы на примере вашей задачи.