Покупатель выбирает товар, переходит к оформлению заказа и указывает, сколько бонусов хочет списать. После нажатия кнопки появляется ошибка. Повторная попытка ничего не меняет.
При этом сайт открывается, серверы доступны, а другие покупатели успешно оформляют заказы. Дежурная команда не видит общего отказа магазина. Поддержка получает жалобу «не могу купить», но пока не знает, что объединяет неудачные попытки.
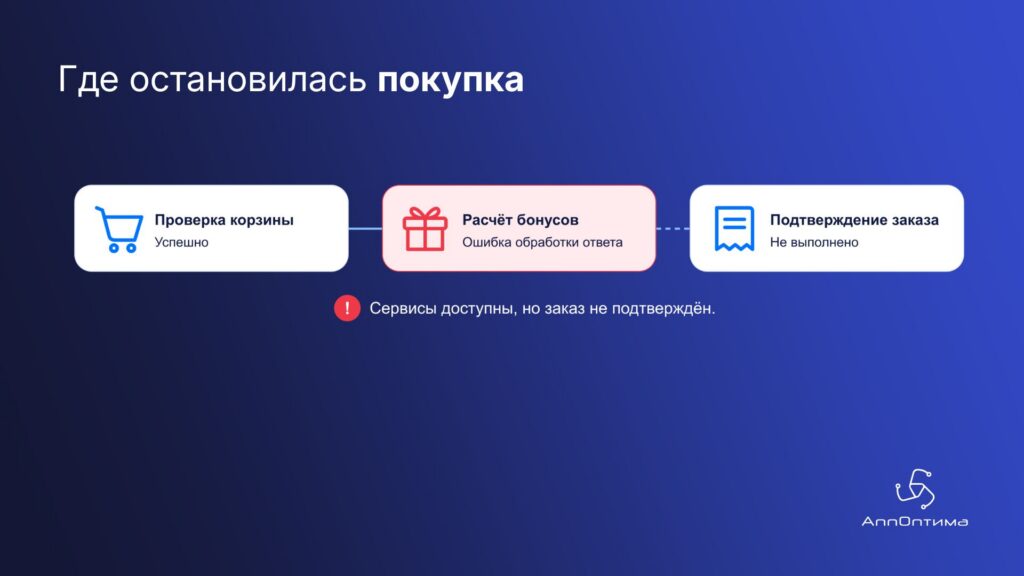
Проблема становится понятнее, если проследить выполнение покупки: проверка корзины прошла, приложение запросило расчет бонусов, а затем обработка остановилась. Теперь у команды есть конкретный участок для проверки и возможность найти другие операции с тем же сбоем.
Такую задачу решает мониторинг бизнес-процессов. Разберем, какие события и показатели нужны для контроля, как по ним перейти к технической причине и с чего начать внедрение. Покупка с бонусами далее используется как условный пример, а не как описание клиентского проекта.
Что такое мониторинг бизнес-процессов и какой результат он дает
Мониторинг бизнес-процессов — это систематическое отслеживание и анализ показателей выполнения бизнес-процессов для своевременного выявления сбоев, задержек и отклонений от установленных значений.
Бизнес-процесс может включать действия сотрудников, работу приложений и обмен данными с внешними организациями. В этой статье рассматриваем цифровые операции, результат которых зависит от ИТ: оформление заказа, проведение платежа, выдачу полиса, регистрацию заявки или подключение услуги.
Для каждой такой операции можно определить начало, значимые этапы, ожидаемый результат и допустимое время выполнения. Например, прием заявки еще не означает подключения услуги. Между ними могут находиться проверка данных, оплата и активация в другой системе. Если контролировать только прием заявки, задержка активации останется за пределами наблюдения.
Настроенный мониторинг должен помогать ответить на четыре вопроса:
- Получен ли результат? Заказ подтвержден, платеж учтен, услуга подключена.
- Получен ли он в срок? Операция не превысила согласованное время выполнения.
- Каков масштаб проблемы? Известны затронутые операции и условия, при которых возникает сбой.
- Где искать причину? Проблемный этап связан с данными приложения, вызовами зависимых систем и ошибками.
Последний вопрос определяет практическую ценность для ИТ-команды. График падения числа заказов помогает заметить изменение. Чтобы устранить сбой, нужно перейти от графика к неудачной покупке и увидеть, что помешало ее завершить. Поэтому при проектировании мониторинга заранее предусматривают такую связь.
Три сбоя, которые не видны по доступности сервисов
Проверка доступности подтверждает, что компонент отвечает на определенный запрос. Реальная операция может требовать другого набора данных, нескольких последовательных вызовов и корректной обработки каждого ответа. Рассмотрим три ситуации, в которых эта разница становится существенной.
Ошибка возникает только у части клиентов
После обновления приложения оформление перестает работать для определенного типа аккаунтов. Остальные клиенты продолжают покупать, поэтому общий показатель успешности меняется незначительно.
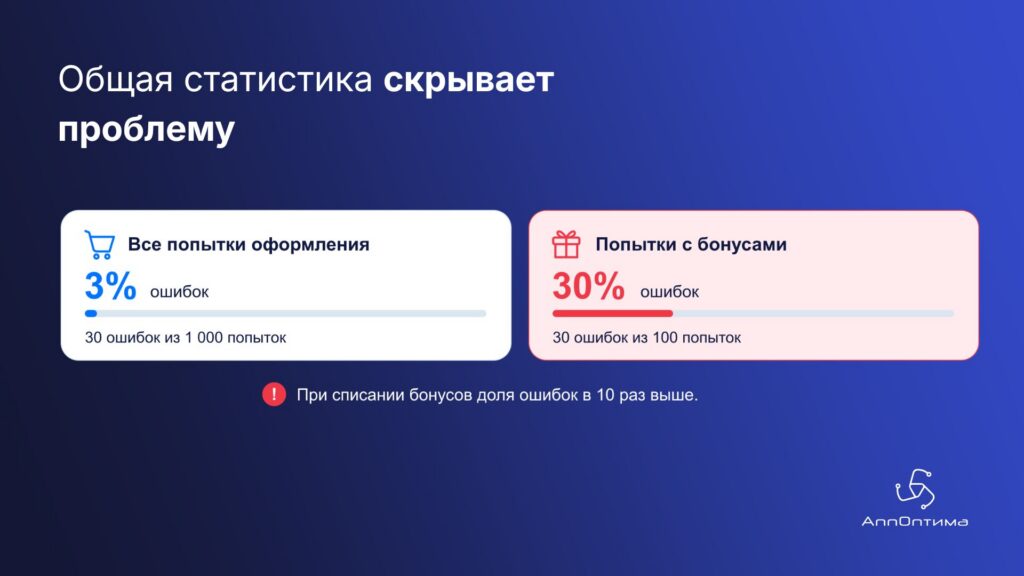
Допустим, из 1 000 попыток оформления 100 включают списание бонусов. Из этих 100 попыток 30 завершаются технической ошибкой. В общей статистике доля ошибок составляет 3%, а внутри сценария с бонусами — 30%. Оба числа верны, но описывают разный масштаб проблемы для конкретной группы покупателей.
Причина может быть связана с обработкой определенного статуса клиента, сочетанием условий заказа или версией мобильного приложения. Для обнаружения нужны признаки, по которым операции можно разделить: канал оформления, версия приложения, способ оплаты, использование бонусов. Собирать следует те признаки, которые действительно помогают проверять рабочие гипотезы.
При анализе сегментов учитывают число наблюдений. Одна ошибка в двух попытках дает 50%, но требует иной оценки, чем 500 ошибок в тысяче попыток. Поэтому долю отказов рассматривают вместе с количеством затронутых операций.
Системы обмениваются данными, но операция завершается отказом
Приложение отправило запрос, зависимый сервис ответил, соединение не прерывалось. Однако полученный ответ не позволяет продолжить процесс: изменился формат поля, отсутствует нужное значение или приложение неверно обрабатывает новый статус.
Например, сервис лояльности вернул расчет, но модуль оформления не смог прочитать сумму доступного списания. Для сетевого обмена запрос завершился, для покупателя — нет. Успешный HTTP-ответ сам по себе не подтверждает успешную покупку.
Здесь нужно различать технический сбой и штатный отказ по правилам бизнеса. Сообщение «недостаточно бонусов» может быть ожидаемым результатом проверки. Ошибка чтения ответа — нарушение обработки. Если объединить их в один показатель, команда будет получать сигналы и о корректном поведении системы.
Контроль должен учитывать смысл результата этапа: расчет выполнен, получен допустимый отказ или возникла техническая ошибка. Для диагностики полезно сохранить тип ошибки и связь с конкретным вызовом. Полные персональные и платежные данные для этого обычно не нужны.
Запрос принят, а следующий этап не наступил
Некоторые операции продолжаются после ответа пользователю. Приложение принимает заявку, помещает сообщение в очередь и показывает статус «в обработке». Далее другая система должна создать документ или подключить услугу.
Если сообщение не обработано, начальный запрос все равно может выглядеть успешным. Явной ошибки в нем нет: проблема проявляется в отсутствии следующего события.
Для такого сценария недостаточно считать ответы с ошибками. Нужны ожидаемый переход и срок: после принятия заявки должно появиться подтверждение обработки. До истечения срока операция находится в ожидании, после — требует проверки. Сам срок определяют по условиям услуги и нормальной длительности процесса.
Отсутствие события еще не доказывает, что операция остановилась. Возможно, результат получен, но данные о нем не поступили в мониторинг. Поэтому при расследовании проверяют и состояние операции в исходной системе, и исправность передачи событий. Это помогает избежать ситуации, когда сбой сбора данных принимают за массовую остановку бизнеса.
Что поставить под контроль в первую очередь
Попытка сразу описать все процессы компании усложняет запуск: у операций разные владельцы, источники данных и условия успешности. Для первого этапа достаточно выбрать одну операцию, согласовать правила контроля и проверить их на реальных данных.
Выберите операцию с понятной ценой сбоя
Начните с операции, сбой в которой приводит к потере продажи, задержке услуги или нарушению обязательств перед клиентом. Например, с приема платежа, оформления заказа или выдачи страхового полиса. Если ошибки в этой операции уже возникали, а для поиска причин приходилось привлекать несколько ИТ-команд, возьмите ее под контроль в первую очередь.
Чтобы определить приоритет, разберите один недавний инцидент. Откуда о нем узнали: из мониторинга, от поддержки или от клиента? Сколько времени ушло на поиск проблемного участка? Удалось ли установить все затронутые операции? Было ли понятно, что произошло с ними после исправления?
Ответы показывают, какую задачу должен решить запуск. Если о сбое узнают из жалоб, нужен более ранний сигнал. Если сигнал приходит быстро, но команды долго обмениваются логами, важнее связать данные для диагностики. Если после восстановления остается список заявок с неизвестным результатом, нужен контроль их конечных состояний.
Зафиксируйте цель в проверяемой форме. Например: «При технической ошибке оформления с бонусами дежурный получает оповещение, находит затронутые попытки и определяет вызов, после которого оформление остановилось». Такой результат можно продемонстрировать на пилоте.
Зафиксируйте начало, результат и допустимый срок
Границы операции определяют, что именно будет измерять система. Нажатие кнопки в браузере и прием запроса сервером — разные начальные события. Если ошибка возникает еще в интерфейсе, в серверной статистике такой попытки может не быть.
Для нашего примера можно выбрать начало «пользователь отправил заполненную форму оформления», а результат — «заказ создан с правильной суммой и подтверждение показано покупателю». Тогда нужно наблюдать и работу приложения, и клиентское действие. Если задача ограничена обработкой принятого сервером запроса, это должно быть явно записано в описании показателя.
Время также измеряют между согласованными событиями. Для подтверждения заказа важна задержка, которую видит покупатель. Для фоновой регистрации документа — срок, в который документ должен появиться в учетной системе. Единого норматива для этих операций нет.
Заранее определите возможные исходы:
- успешное завершение;
- штатный отказ по правилам бизнеса;
- техническая ошибка;
- отмена пользователем;
- ожидание результата.
Дополнительно отмечайте превышение срока: операция может завершиться успешно, но слишком поздно. Такая покупка не должна исчезать из статистики задержек после получения подтверждения.
Правила учета согласовывают владелец процесса и техническая команда. Например, отказ из-за отсутствия товара может исключаться из расчета технической надежности, но оставаться в анализе конверсии. Главное — не менять состав показателя от инцидента к инциденту и не скрывать исключенные исходы.
Определите контрольные события и ответственных
Для начала не нужно превращать каждый внутренний вызов в отдельный этап процесса. Выделите события, по которым можно установить продвижение операции и участок остановки.
Для условного оформления с бонусами карта может выглядеть так:
| Этап | Что подтверждает выполнение | Где искать данные | Кто проверяет проблему |
| Начало оформления | Форма отправлена, попытке присвоен идентификатор | Клиентское приложение и сервис оформления | Команда оформления |
| Проверка корзины | Подтверждены состав, цены и доступность | Сервис корзины | Команда корзины |
| Расчет бонусов | Получен и обработан результат расчета | Приложение и интеграция с лояльностью | Команда интеграции |
| Создание заказа | Сохранен заказ с итоговой суммой | Сервис заказов | Команда заказов |
| Подтверждение клиенту | Приложение показало результат оформления | Клиентское приложение | Команда клиентского приложения |
События должны относиться к одной операции. Для этого нужен идентификатор, который передается между участниками процесса либо сопоставляется по известным правилам. До создания заказа удобно использовать идентификатор попытки, а затем связать его с номером заказа.
Повторное нажатие кнопки, повтор сетевого запроса и новый заказ — разные события. Их связь нужно сохранить, чтобы не посчитать несколько технических повторов как несколько потерянных продаж. В асинхронном процессе дополнительно проверяют передачу идентификатора через сообщения и фоновые задачи.
Результат этого этапа — краткое описание операции: границы, исходы, сроки, контрольные события, источники данных и ответственные команды. По нему можно ставить задачу на подключение мониторинга и проверять полноту собранных данных.
Какие показатели и оповещения нужны для контроля процесса
Мониторинг бизнес-показателей помогает оценить изменение результата: сколько заказов создано, сколько заявок обработано, какая доля операций завершилась в срок. Для оперативного контроля важно, чтобы показатели позволяли выбрать конкретные операции для проверки.
На старте достаточно пяти измерений: доли своевременных успешных завершений, числа технических отказов, числа просроченных незавершенных операций, длительности этапов и количества затронутых операций в значимых сегментах. Дополнительные показатели вводят под вопросы, на которые этот набор не отвечает.
Успешное завершение в срок
Базовый показатель объединяет результат и время выполнения:
Доля успешных операций в срок = число операций, успешно завершенных в пределах установленного срока / число операций, включенных в расчет × 100%.
Знаменатель требует отдельного правила. Если включить в расчет только что начавшиеся операции, у которых еще есть время на выполнение, часть нормального ожидания будет выглядеть как неуспех. Один из способов избежать этого — оценивать группу операций, для каждой из которых допустимый срок уже истек к моменту расчета.
Рассмотрим условные данные. Из 500 таких операций 480 завершились успешно вовремя, 8 — успешно с задержкой, 7 — с технической ошибкой, 5 остаются незавершенными. Доля своевременного успеха составляет 480 / 500 × 100% = 96%. В этом примере все 500 операций включены в расчет; отмен и штатных отказов в группе нет.
Полученное число показывает общий результат, а распределение оставшихся 20 операций подсказывает, что проверять: задержки, явные ошибки или отсутствие завершения. Если оставить только один процент, эти разные проблемы смешаются.
Для показателя фиксируют начальное и конечное события, допустимый срок, временное окно и исключения. Также определяют, как пересчитывать данные при позднем поступлении событий. Это делает результаты сопоставимыми между периодами и командами.
Зависшие операции и задержки между этапами
Показатель длительности завершенных операций не описывает те, которые еще находятся в работе. Поэтому отдельно контролируют количество незавершенных операций с превышенным сроком и возраст самой старой из них.
Для каждой такой операции полезно знать последнее подтвержденное событие. Например, расчет бонусов закончен, но заказ не создан. Это сужает область поиска до перехода между двумя этапами, хотя само по себе еще не устанавливает причину задержки.
Измерять нужно и выполнение действий, и ожидание между ними. Обработчик может работать быстро после получения задания, а заявка — долго находиться в очереди до запуска обработчика. Если учитывать только длительность вызова, основная задержка не попадет в показатель.
Для оценки скорости используют распределение времени выполнения. Например, p95 — время, за которое завершились 95% наблюдаемых операций. Оно помогает увидеть медленные выполнения, которые скрывает среднее значение. Но p95 завершенных операций также не заменяет контроль незавершенных.
Разбор задержек должен приводить к конкретному вопросу: долго выполняется вызов, накапливается очередь, не происходит передача между системами или ожидается действие сотрудника? Для каждого варианта нужны свои данные и ответственный.
Проблемные сегменты и масштаб влияния
Сегментация помогает проверить, одинаково ли работает процесс для разных условий. В примере с покупкой полезны использование бонусов, канал оформления и версия приложения. В другой компании это могут быть вид услуги, регион обработки или партнерская система.
Набор признаков выбирают до инцидента: если нужный атрибут не собирается, восстановить его задним числом бывает невозможно. При этом не стоит добавлять в события все доступные сведения о клиенте. Для большинства технических разборов достаточно ограниченного набора признаков и идентификаторов с соответствующими правами доступа.
Масштаб влияния оценивают в нескольких единицах: неудачные попытки, уникальные операции, затронутые пользователи. Эти числа могут различаться. Один покупатель способен сделать несколько повторных попыток, после чего все же оформить заказ.
Сумму корзин с ошибкой нельзя автоматически объявлять потерянной выручкой. Часть покупателей завершит покупку позже или через другой канал. Для финансовой оценки нужно сопоставить попытки с фактическими заказами и платежами. До такой сверки корректнее говорить о сумме заказов под риском.
Такое разделение помогает расставлять приоритеты без завышения ущерба. Команда видит текущий масштаб технической проблемы, а владелец процесса получает данные для отдельной оценки бизнес-последствий.
Оповещение, по которому можно начать расследование
Полезное оповещение сообщает, какая операция нарушена, что изменилось, когда началось отклонение и где открыть примеры. Сообщения «ошибка приложения» для этого недостаточно.
Пример содержания оповещения:
- Операция: оформление заказа с бонусами.
- Отклонение: выросла доля технических отказов.
- Проблемный участок: обработка результата расчета бонусов.
- Затронутый сегмент: веб-приложение, определенная версия.
- Данные для проверки: количество попыток и отказов, время начала, идентификаторы примеров, связанные ошибки и трассировки.
- Ответственная команда: команда оформления.
Это образец состава сообщения, а не описание готового интерфейса продукта. Конкретные поля зависят от собранных данных и правил оповещения.
Порог выбирают с учетом объема операций и цены задержки. При большом потоке важен рост доли отказов, при редких критичных операциях — отдельное превышение срока. Для полного прекращения успешных операций может потребоваться более быстрая реакция, чем для умеренного ухудшения.
Мониторинг бизнес-процессов в реальном времени имеет практический смысл, когда задержка сбора, расчета и доставки сигнала позволяет вовремя вмешаться. На пилоте измеряют весь этот интервал, а не только частоту обновления графика. Отдельно проверяют, заметит ли команда остановку самого потока данных.
Как найти причину сбоя: от сигнала до исправления
Вернемся к условной покупке с бонусами. Мониторинг обнаружил рост технических отказов в определенной версии веб-приложения. Следующая задача — получить доказательства, по которым разработчики смогут исправить проблему.
От показателя к конкретной операции
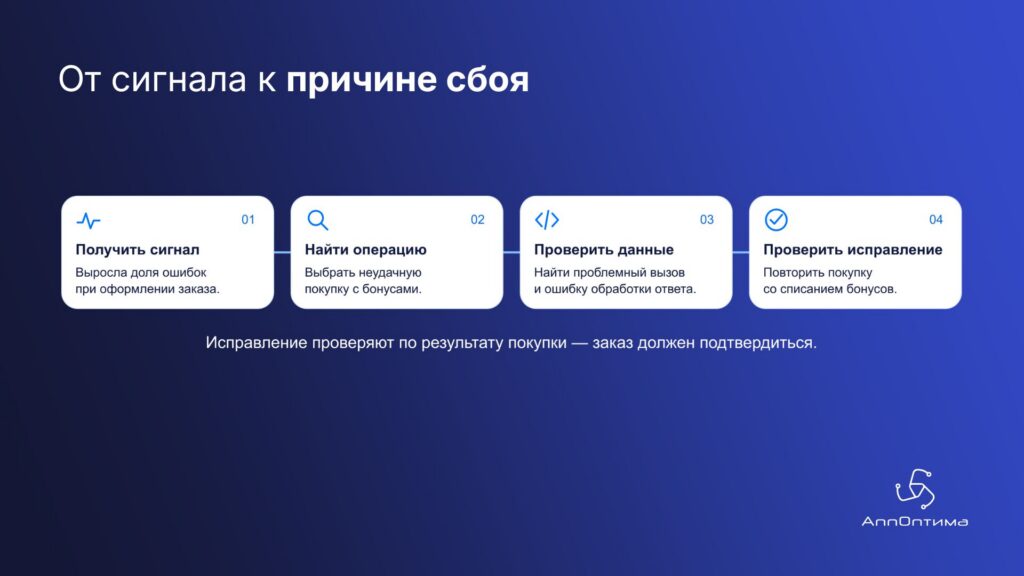
Дежурный выбирает несколько неудачных попыток из проблемного сегмента. Сначала проверяет, действительно ли у них одинаковая последовательность событий: начало оформления есть, корзина проверена, расчет бонусов запрошен, подтвержденного заказа нет.
Затем сопоставляет данные клиентского приложения и сервера. Это позволяет различить ситуации, внешне похожие для покупателя. В одной заказ вообще не создан, в другой — создан, но подтверждение не дошло до интерфейса. Дальнейшие действия в этих случаях будут разными.
Поэтому отсутствие события в мониторинге проверяют по данным системы, которая хранит фактическое состояние заказа. Если номер заказа еще не появился, поиск выполняют по идентификатору попытки. Если появился — используют связь между ними.
Для сравнения выбирают успешную операцию с близкими условиями. Она помогает увидеть, на каком этапе поведение расходится. При этом сходство должно быть содержательным: покупка без бонусов может подтвердить общую работоспособность оформления, но не корректность обработки бонусного расчета.
Результат первого шага — несколько проверенных примеров сбоя, общий проблемный участок и понимание, какие действия успели выполниться. Это основа дальнейшего расследования.
От проблемного этапа к вызову, ошибке и версии приложения
Теперь команда открывает технические данные выбранной попытки. Трассировка показывает последовательность вызовов и их длительность, ошибки и логи помогают понять, что произошло внутри обработчика.
Предположим, в нашем условном примере сервис лояльности ответил быстро, но после получения ответа приложение выдало исключение при чтении одного поля. Проверка показывает: ошибка появляется в новой версии обработчика и воспроизводится для определенного варианта ответа.
Такой набор сведений существенно точнее формулировки «сломалась интеграция». Он указывает на место обработки, тип данных и условия возникновения ошибки. Команде не приходится начинать с проверки всех зависимостей магазина.
Связь с релизом рассматривают как гипотезу, которую нужно подтвердить. Совпадение времени обновления и начала отказов само по себе недостаточно. Проверяют, изменялся ли соответствующий код, возникает ли ошибка в предыдущей версии и воспроизводится ли она на тех же входных данных.
В результате задача на исправление содержит:
· описание нарушенной операции и условий сбоя;
· время начала и затронутые версии;
· примеры попыток с идентификаторами;
· проблемный вызов или метод и тип ошибки;
· ожидаемое и фактическое поведение;
· оценку масштаба по доступным данным.
Не каждый инцидент удастся довести до причины только по собранным данным. Например, внешняя система может быть доступна лишь как точка вызова и ответа. Но и в этом случае связанная история операции позволяет передать ее владельцу конкретное обращение и время сбоя вместо общей жалобы.
От исправления к проверке затронутых заказов
После изменения кода проверяют тот же сценарий, на котором возникала ошибка: соответствующий тип клиента, способ расчета и вариант ответа. Успешная покупка в другом сегменте еще не подтверждает устранение проблемы.
Далее наблюдают за новым потоком операций. Доля ошибок должна вернуться к согласованному уровню, время выполнения — укладываться в установленный предел. При этом отсутствие новых ошибок на фоне отсутствия самих попыток нельзя считать доказательством восстановления.
Отдельная задача — разобраться с операциями, затронутыми до исправления. Например, бонусы могли быть зарезервированы, а заказ не создан. Или заказ появился, но клиент не получил подтверждение и повторил действие.
Для таких операций проверяют конечные состояния в системах заказов, платежей и лояльности. Повторную обработку выполняют по предусмотренным правилам, учитывая уже совершенные действия и защиту от дублей. Массовый повтор всех неудачных запросов без этой проверки способен создать новые проблемы.
Инцидент можно считать обработанным, когда подтверждена работоспособность новых операций и определена судьба ранее затронутых. В итогах сохраняют причину, способ обнаружения, выполненное исправление и изменения в контроле, которые помогут быстрее разобрать похожую ситуацию.
Как запустить мониторинг одного процесса и проверить результат
Системы мониторинга бизнес-процессов стоит оценивать на операции компании, для которой известны участники, ожидаемый результат и характерные сбои. Демонстрация общего дашборда не показывает, удастся ли найти причину конкретного отказа в вашей архитектуре.
Пилот удобно организовать как последовательность проверяемых действий: описать операцию, подключить данные, проверить их связь, воспроизвести согласованные отклонения и оценить результат расследования.
Подготовьте данные и подключите выбранный контур
До установки согласуйте состав участников. Владелец процесса определяет результат и допустимые сроки. Команды приложений подтверждают события и идентификаторы. Специалисты эксплуатации настраивают наблюдение и оповещения. Поддержка помогает проверить, достаточно ли данных для разбора клиентского обращения.
Для подключения подготовьте:
1. Карту операции. Начало, этапы, исходы и сроки, которые нужно контролировать.
2. Перечень систем. Клиентское приложение, серверные компоненты, очереди и внешние зависимости в границах пилота.
3. Источники данных. События результата, трассировки, логи, ошибки и показатели состояния компонентов.
4. Правила связи. Идентификаторы попытки и заказа, передача контекста, учет повторов.
5. Сегменты. Признаки, по которым нужно находить частичные сбои.
6. Маршрут реакции. Кто получает сигнал, кто разбирает причину и кто проверяет результат исправления.
После подключения проведите несколько известных операций и найдите их в собранных данных. Сравните этапы и результаты с исходными системами. Проверьте, что события не теряются на асинхронном переходе и не дублируются при повторной отправке.
Отдельно выясните, какие данные собираются полностью, а какие — выборочно. Выборка трассировок может помогать диагностике, но не дает основания объявлять точное количество всех неудачных заказов. Для точных бизнес-показателей нужен источник с проверенной полнотой учета либо явно обозначенная оценка.
Если часть процесса пока не наблюдается, зафиксируйте этот участок и способ проверки. Так команда понимает границы пилота и не принимает отсутствие данных за подтвержденный успех.
Проверьте наблюдение на трех сценариях сбоя
Проверки проводят в согласованной среде и в согласованных границах. Для первого пилота полезны три сценария, потому что они проверяют разные механизмы обнаружения.
Явная техническая ошибка. Один из этапов завершается отказом. Нужно убедиться, что операция попала в показатель, сформировано оповещение, а из примера можно перейти к связанным техническим данным.
Задержка или отсутствие следующего события. Начало есть, ожидаемого продолжения нет. Проверяют, что до допустимого срока операция находится в ожидании, после срока обнаруживается отклонение, а позднее завершение корректно учитывается в истории.
Сбой ограниченного сегмента. Проблема возникает только для выбранной версии приложения или определенных условий операции. Проверяют, что общий поток успешных операций не скрывает отклонение и команда может выделить затронутую группу.
Для каждого сценария фиксируют время возникновения, поступления данных, отправки сигнала и получения сведений о проблемном участке. Эти отметки позволяют понять, что именно задерживает реакцию: сбор, правило оповещения или ручное расследование.
Также проверяют повторные попытки и восстановление. Одно событие не должно порождать несколько одинаковых инцидентов из-за дублирования данных. Оповещение должно закрываться по согласованному условию восстановления, а просроченные операции — сохраняться в истории даже после завершения.
Зафиксируйте критерии приемки пилота
До запуска договоритесь, по каким результатам команда примет решение о дальнейшем внедрении. Удобно использовать короткую таблицу с доказательствами, которые нужно получить.
| Критерий | Что проверить на пилоте |
| Видимость операции | У тестовых попыток определены этапы, результат и длительность; пробелы обозначены |
| Обнаружение сбоя | Все согласованные сценарии обнаружены в установленный для них срок |
| Оценка масштаба | Можно выделить затронутые операции и сегменты, понятны полнота данных и правила учета повторов |
| Данные для диагностики | От неудачной операции можно перейти к связанному вызову, ошибке и доступному техническому контексту |
| Ответственность | Сигнал получает нужная команда, порядок передачи между участниками понятен |
| Проверка восстановления | Видно состояние новых операций и доступен список ранее затронутых для сверки |
Численные требования определяют для выбранного процесса. Важны допустимая задержка обнаружения, охват событий и время получения диагностических данных. Не стоит подставлять универсальные значения, которые не связаны с условиями услуги и возможностями команды.
Если цель — сократить время расследования, сравните разбор сопоставимого сценария до подключения и во время пилота. Учитывайте, какие данные были доступны и какие действия выполнялись вручную. Такое сравнение полезнее обещания заранее заданного процента улучшения.
По итогам должно быть понятно, какие задачи решены, где нужен дополнительный сбор данных и какой процесс подключать следующим. Основанием для расширения служит проверенная способность команды обнаружить и разобрать сбой.
АппОптима: подключите мониторинг ваших бизнес-процессов
Для описанного подхода нужно связать клиентское действие, выполнение запросов и состояние участвующих систем. АппОптима объединяет наблюдение за пользовательским опытом, производительностью приложений и инфраструктурой, помогая исследовать сбой в контексте операции.
Практическая задача такого подключения — сократить объем ручного сопоставления данных. При жалобе на оформление заказа команда должна иметь возможность проследить связанное выполнение и определить, какой участок требует проверки.
Свяжите клиентский сценарий с приложениями и инфраструктурой
Наблюдение за пользовательским опытом, или RUM, помогает исследовать действия, ошибки и задержки в веб- и мобильных приложениях. APM дает технический контекст выполнения: транзакции, трассировки, длительность вызовов и зависимости. Данные инфраструктуры дополняют картину состоянием ресурсов, на которых работает приложение.
В примере с бонусами это разные части одного расследования. Сначала нужно увидеть неудачное действие покупателя. Затем — найти связанное выполнение на сервере и обращение к лояльности. После этого проверить ошибку обработки и состояние компонентов, если они могли повлиять на результат.
Для анализа бизнес-сценария заранее согласуют необходимые атрибуты транзакций и настраивают их сбор. Например, признак использования бонусов помогает отделить такие попытки от остальных. Полнота связи между действием пользователя и техническими данными зависит от подключенных компонентов и передачи контекста; ее проверяют на выбранном сценарии.
Так мониторинг бизнес-сервисов получает привязку к вопросу, с которым приходит бизнес: почему определенная операция не завершается и какие клиенты сталкиваются с проблемой.
Находите причину в контексте операции
АппОптима позволяет использовать связанные метрики, логи, трассировки, события и зависимости для поиска проблемного участка. В ходе разбора команда может исследовать длительные вызовы, ошибки и доступные детали выполнения методов приложения.
Если есть необходимые метаданные, техническую картину можно сопоставить с изменениями версии приложения. Это помогает проверить гипотезу о влиянии релиза: какие операции затронуты, в какой версии они выполнялись и где отличается их поведение.
Возможности AI/ML используются для выявления аномалий и помощи в определении вероятной первопричины. Вывод проверяют по исходным данным. Решение об исправлении остается за специалистами, которым нужны конкретные доказательства: проблемный вызов, ошибка, зависимость или изменение поведения.
На демонстрации имеет смысл пройти всю последовательность на одном примере: выбрать неудачную операцию, открыть связанные данные, найти участок отклонения и определить следующий шаг проверки. Именно этот путь показывает, насколько платформа помогает вашей команде расследовать инциденты.
Начните с одного приложения или процесса
Для подключения поддерживаемых компонентов АппОптима использует единый агент с автоматическим обнаружением; для мобильных приложений предусмотрен SDK. Состав подключения определяют после оценки технологического стека и границ выбранной операции.
Первым шагом может стать оформление заказа, проведение платежа или обработка заявки. Для этого процесса вместе с командой АппОптимы определите источники данных, значимые события, показатели и сценарии проверки. Затем оцените результат по тем же критериям, которые будут важны в эксплуатации.
Если операция включает длительное ожидание, внешние статусы или несколько асинхронных переходов, отдельно проверьте получение этих данных и способ контроля сроков. Установка агента и описание бизнес-результата решают разные части задачи: критерии успеха и правила учета задает компания.
На пилоте стоит получить три конкретных результата: обнаружить согласованный сбой, установить затронутые операции в пределах проверенного охвата и пройти от примера ошибки к техническим данным, достаточным для дальнейшей диагностики. По итогам можно обоснованно решить, как расширять мониторинг.
Обсудите с командой АппОптимы подключение вашей критичной операции. Выберите заказ, платеж или заявку, сбой в которых обходится бизнесу дорого, и проверьте на демонстрации или пилоте, как платформа помогает обнаружить проблему и найти ее причину.